2026
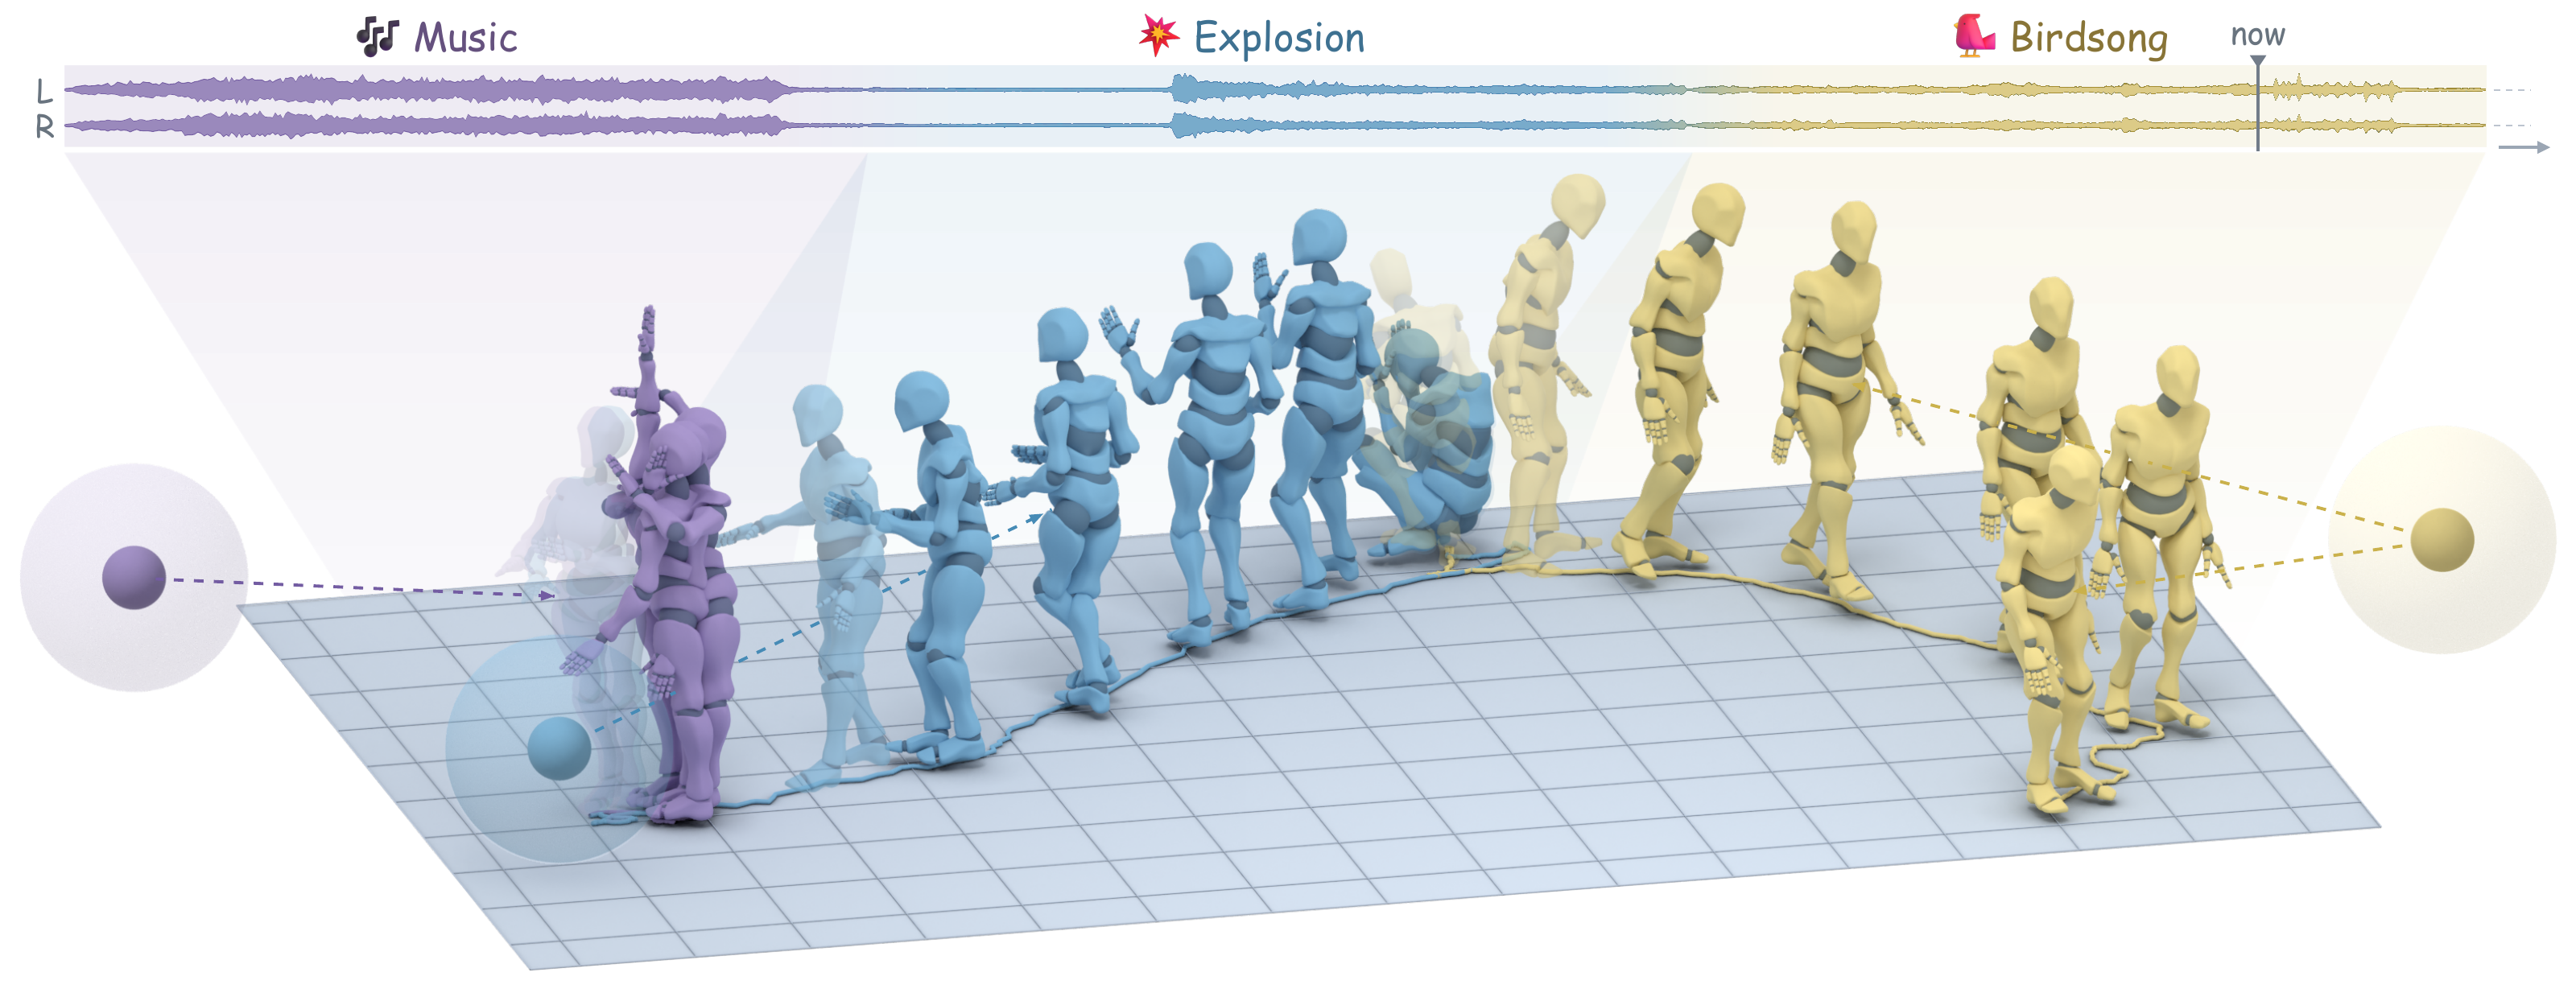
Sonic-AMG: Streaming Human Motion Generation from Spatial Audio
Jingcheng Ni, Zekun Li, Zhiyang Dou, Xiaoyan Cong, Ziyao Zeng, Hongyang Du, Randall Balestriero, Taku Komura, Srinath Sridhar
arXiv 2026
TL;DR: Generating human motion in real time as spatial audio arrives.
Sonic-AMG: Streaming Human Motion Generation from Spatial Audio
Jingcheng Ni, Zekun Li, Zhiyang Dou, Xiaoyan Cong, Ziyao Zeng, Hongyang Du, Randall Balestriero, Taku Komura, Srinath Sridhar
arXiv 2026
TL;DR: Generating human motion in real time as spatial audio arrives.
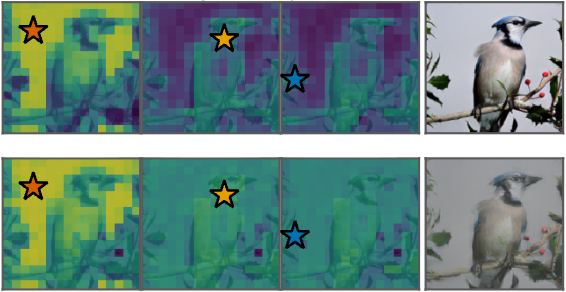
FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders
Hongyang Du, Yunfei Xie, Junjie Ye, Jiawei Yang, Xiaoyan Cong, Haodong Zhang, Yongchao Huang, Haiyu Wu, Zongxia Li, Shihang Gui, Dawei Liu, Runhao Li, Jingcheng Ni, Chen Wei, Randall Balestriero, Yue Wang
arXiv 2026 #1 HuggingFace Daily Paper
TL;DR: A very simple regularization can mitigate the reconstruction-generation gap.
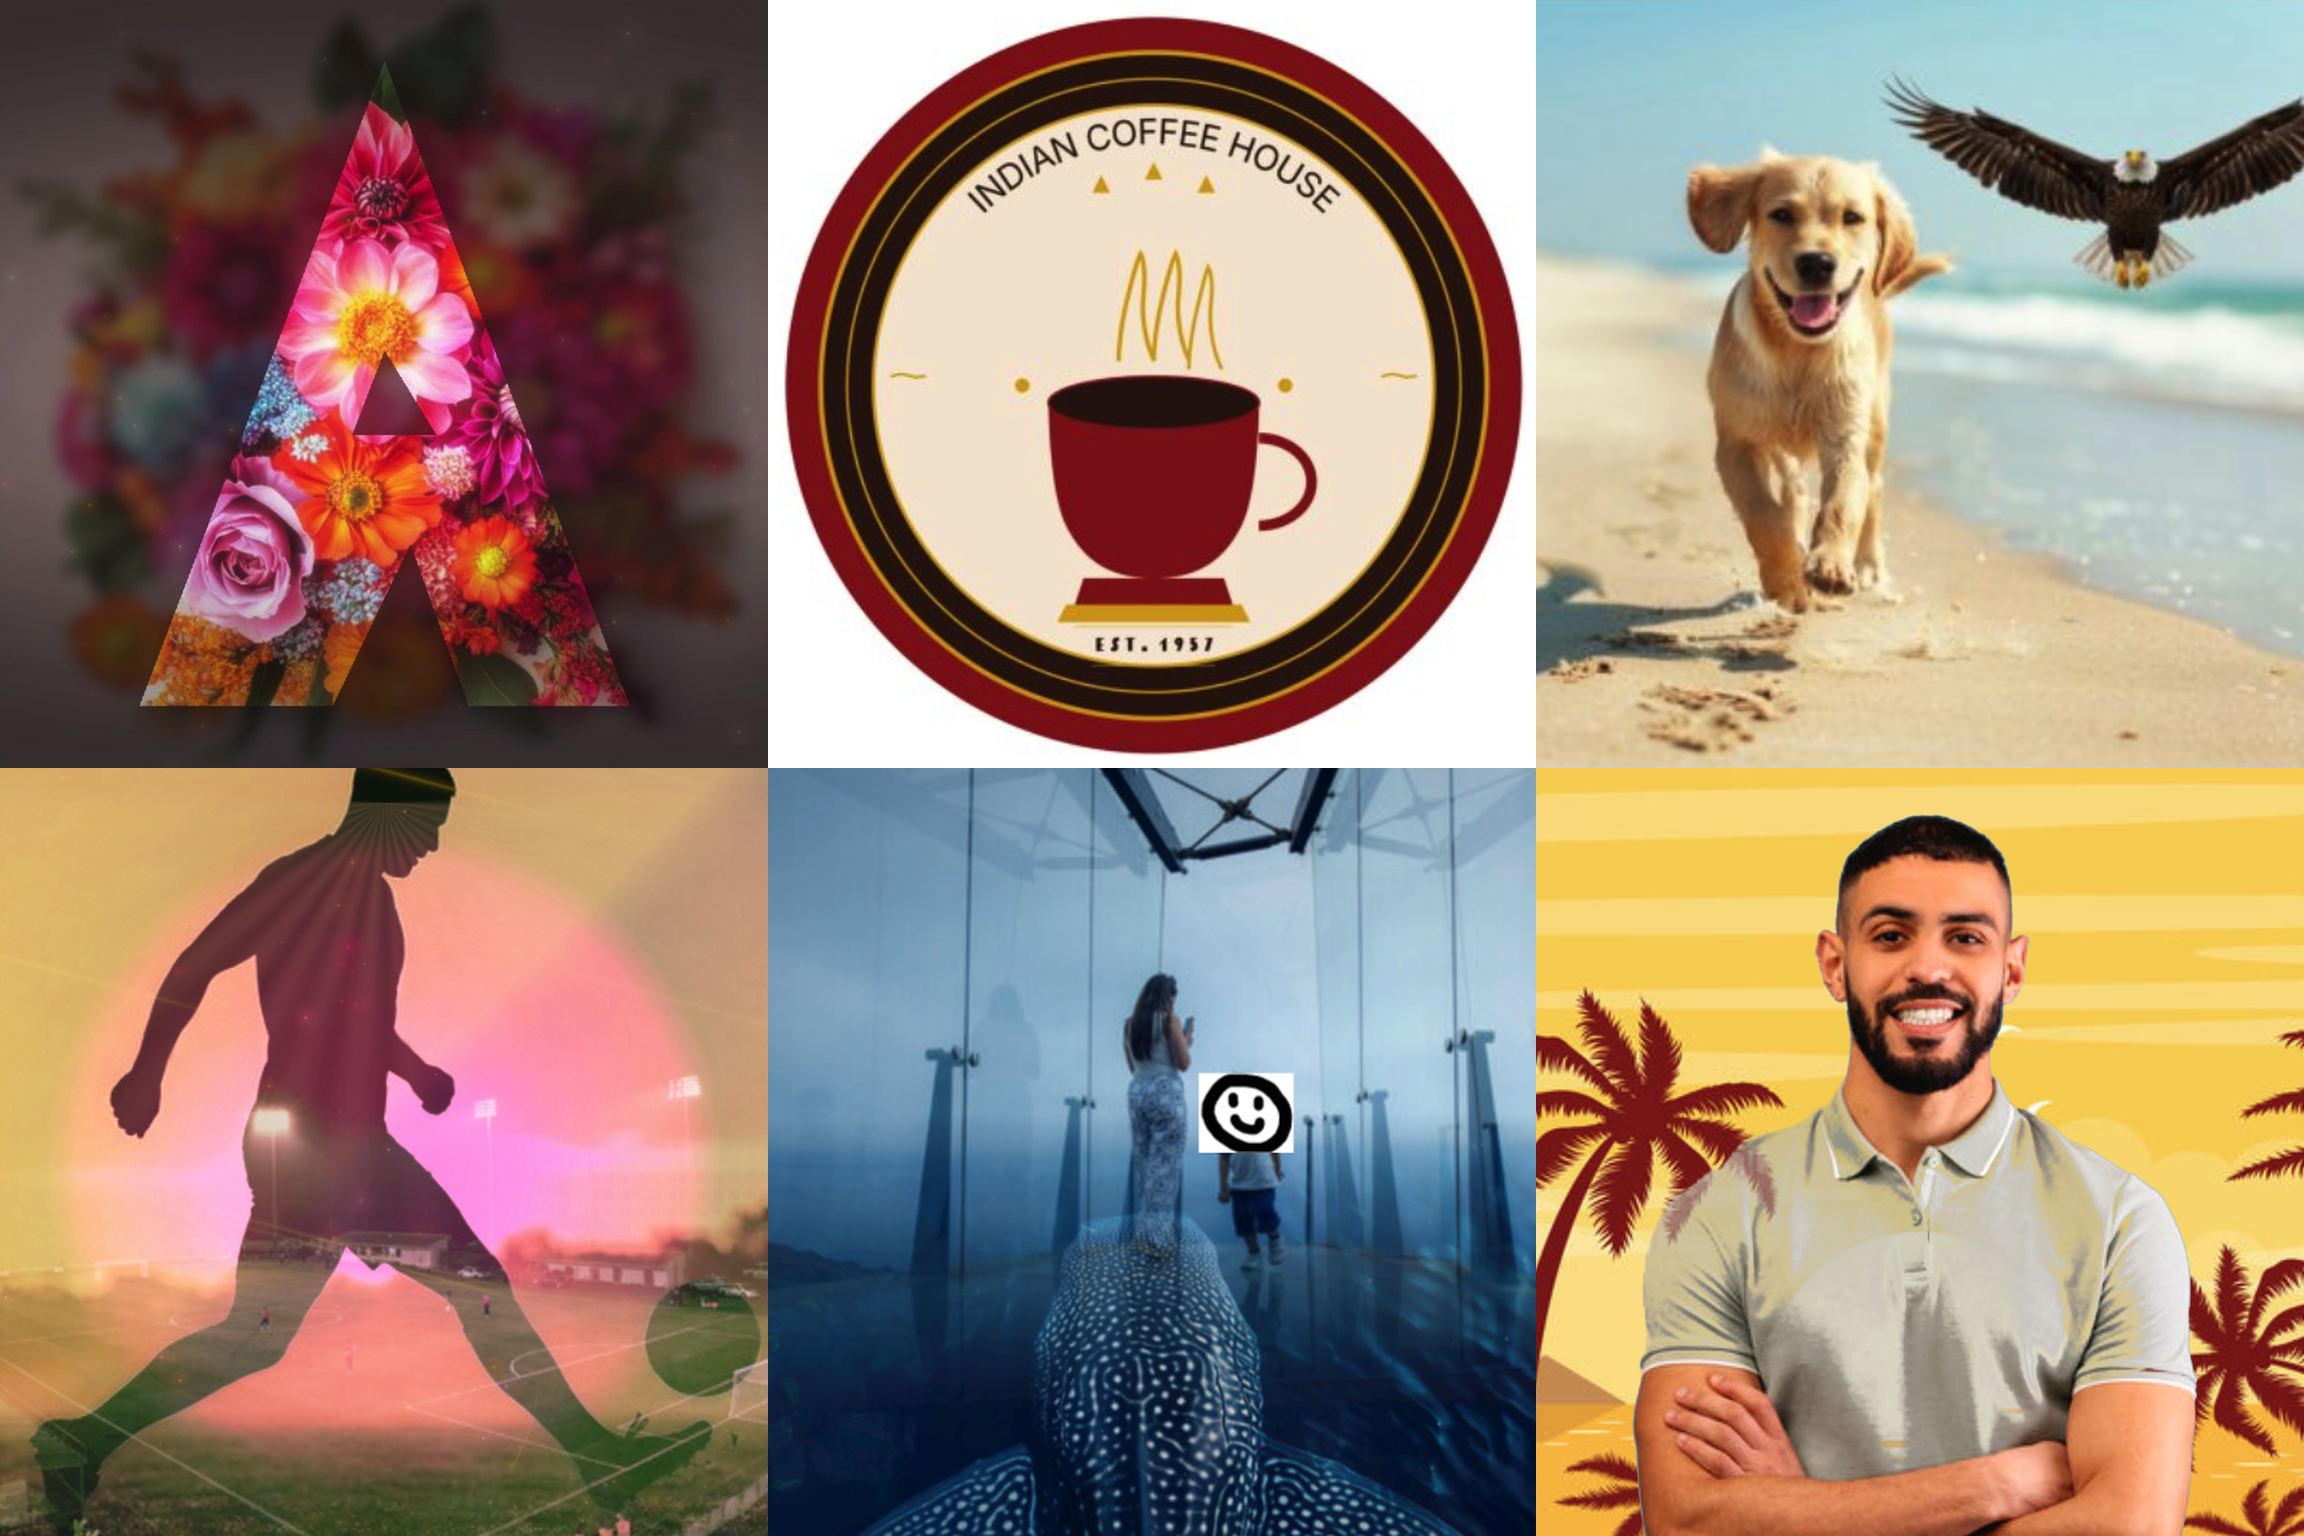
Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
Hongyang Du, Lan Yan, Christian Flores, Asim Kadav
NeurIPS 2026 Workshop CLEA Oral
TL;DR: A design agent that keeps learning new skills from real users without retraining.
Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
Hongyang Du, Lan Yan, Christian Flores, Asim Kadav
NeurIPS 2026 Workshop CLEA Oral
TL;DR: A design agent that keeps learning new skills from real users without retraining.
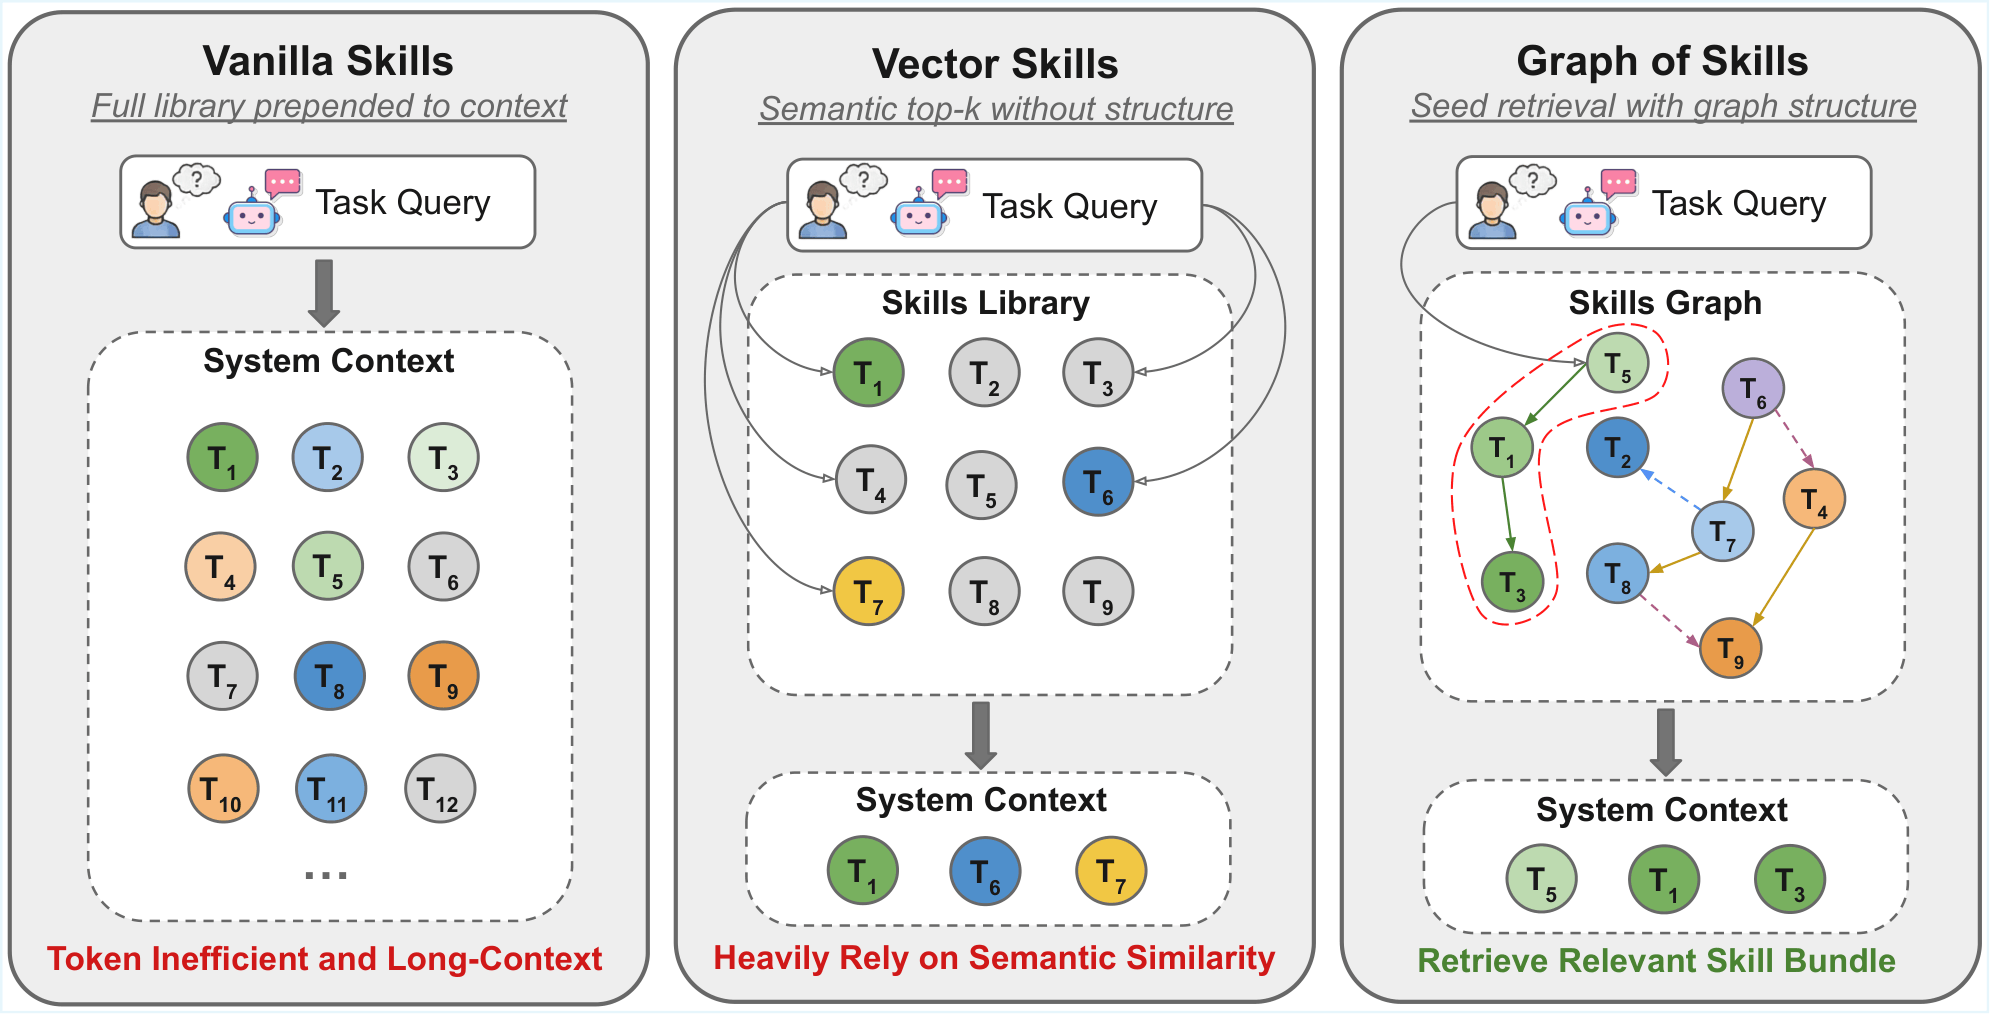
Graph of Skills: Dependency-Aware Structural Retrieval for Massive Agent Skills
Dawei Liu*, Zongxia Li*, Hongyang Du, Xiyang Wu, Shihang Gui, Yongbei Kuang, Lichao Sun
EMNLP 2026
TL;DR: Helping AI agents find just the skills they need from a huge skill library.
Graph of Skills: Dependency-Aware Structural Retrieval for Massive Agent Skills
Dawei Liu*, Zongxia Li*, Hongyang Du, Xiyang Wu, Shihang Gui, Yongbei Kuang, Lichao Sun
EMNLP 2026
TL;DR: Helping AI agents find just the skills they need from a huge skill library.
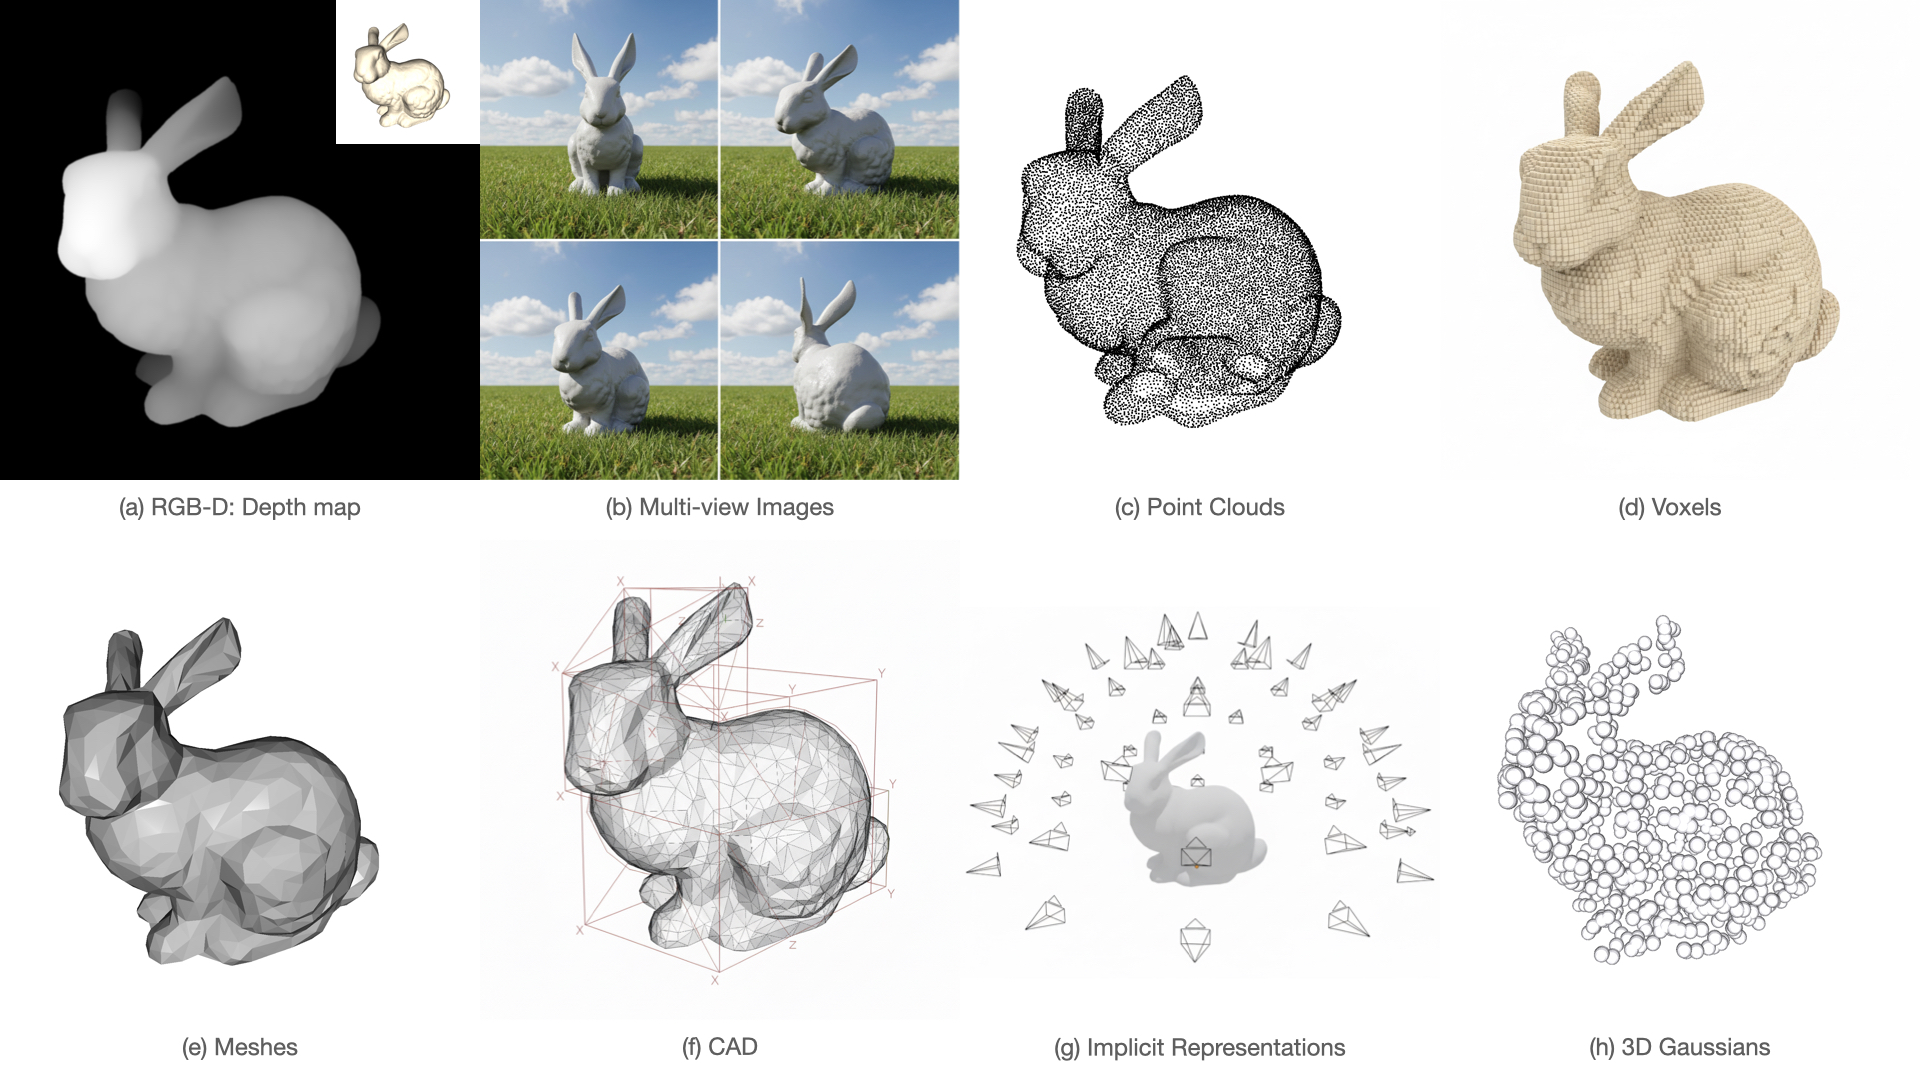
A Cookbook of 3D Vision: Data, Learning Paradigms, and Application
Hongyang Du*, Zongxia Li*, Dawei Liu*, Runhao Li*, Haoyuan Song, Qingyu Zhang, Yubo Wang, Jingcheng Ni, Shihang Gui, Congchao Dong, Tao Hu
CVPR Workshop 2026
TL;DR: A guide to 3D vision data, methods, and applications.
A Cookbook of 3D Vision: Data, Learning Paradigms, and Application
Hongyang Du*, Zongxia Li*, Dawei Liu*, Runhao Li*, Haoyuan Song, Qingyu Zhang, Yubo Wang, Jingcheng Ni, Shihang Gui, Congchao Dong, Tao Hu
CVPR Workshop 2026
TL;DR: A guide to 3D vision data, methods, and applications.
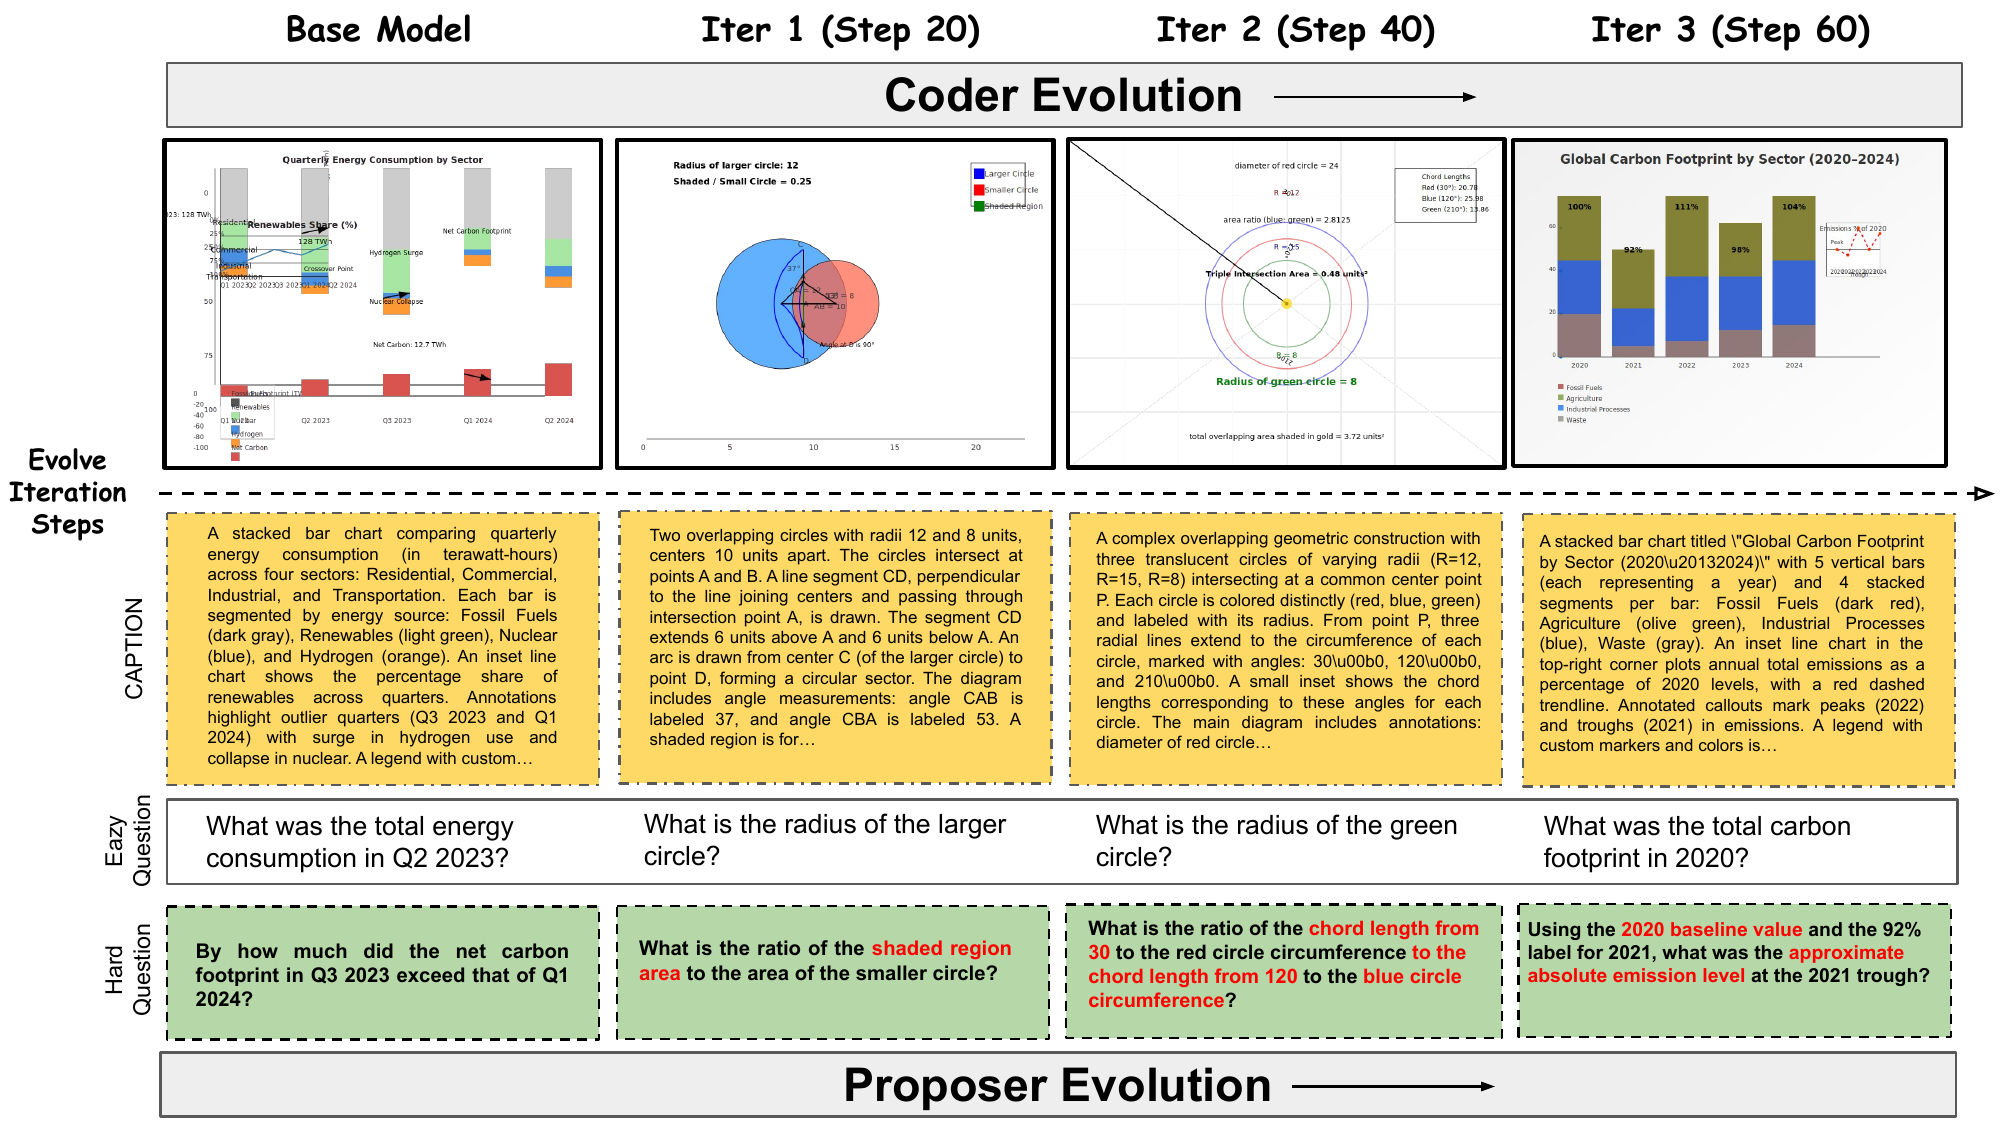
MM-Zero: Self-Evolving Multi-Model Vision Language Models From Zero Data
Zongxia Li*, Hongyang Du*, Chengsong Huang*, Xiyang Wu, Lantao Yu, Yicheng He, Jing Xie, Xiaomin Wu, Zhichao Liu, Jiarui Zhang, Fuxiao Liu
EMNLP 2026
TL;DR: A vision-language model that improves itself without any training data.
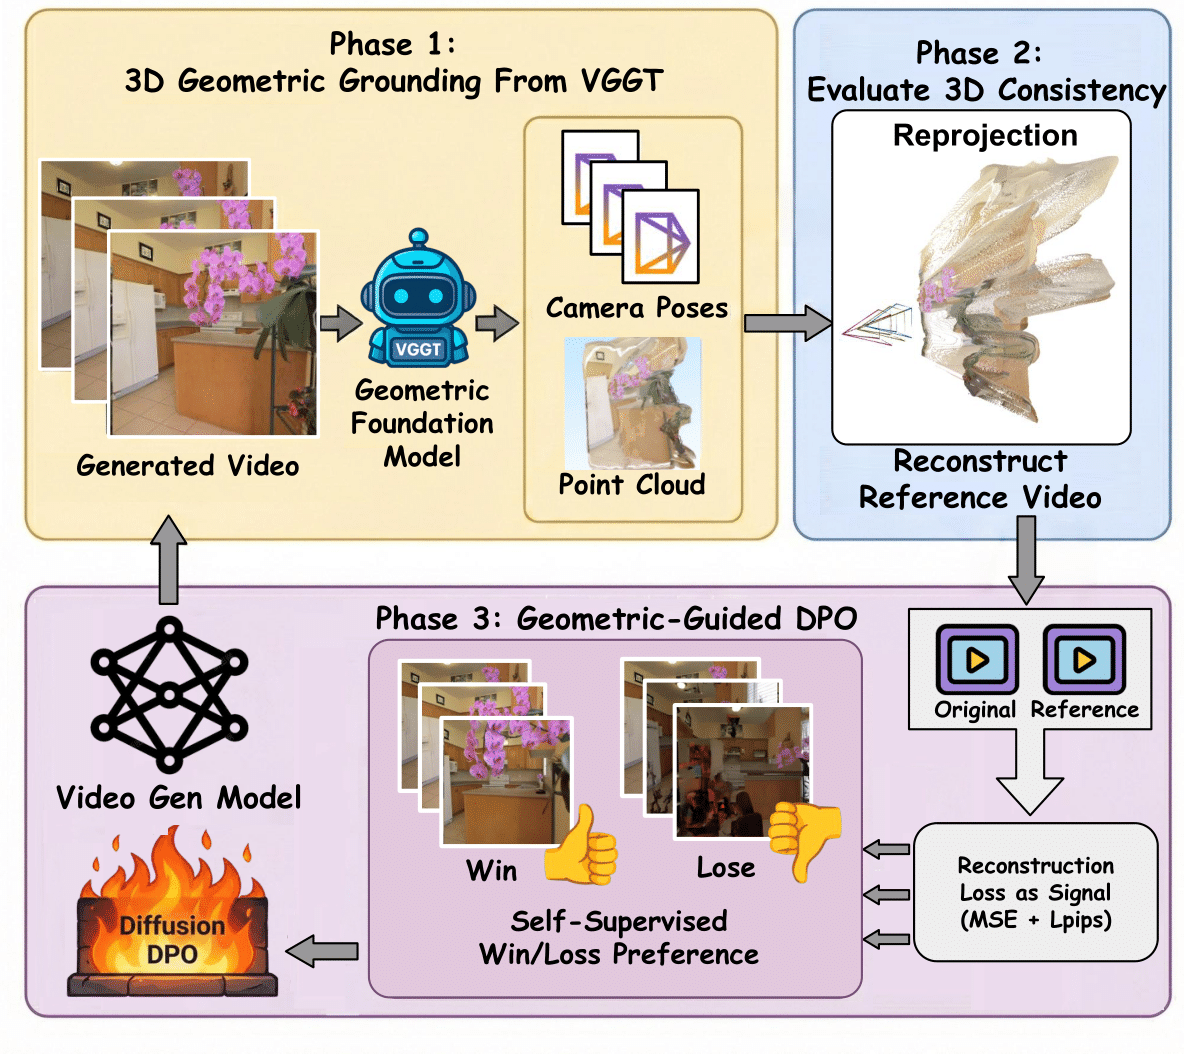
VideoGPA: Distilling Geometry Priors for 3D-Consistent Video Generation
Hongyang Du*, Junjie Ye*, Xiaoyan Cong*, Runhao Li, Jingcheng Ni, Aman Agarwal, Zeqi Zhou, Zekun Li, Randall Balestriero, Yue Wang
ICML 2026 CVPR VGBE Challenge 🏆 Oral
TL;DR: Using 3D geometry knowledge to make generated videos more 3D-consistent.
2025
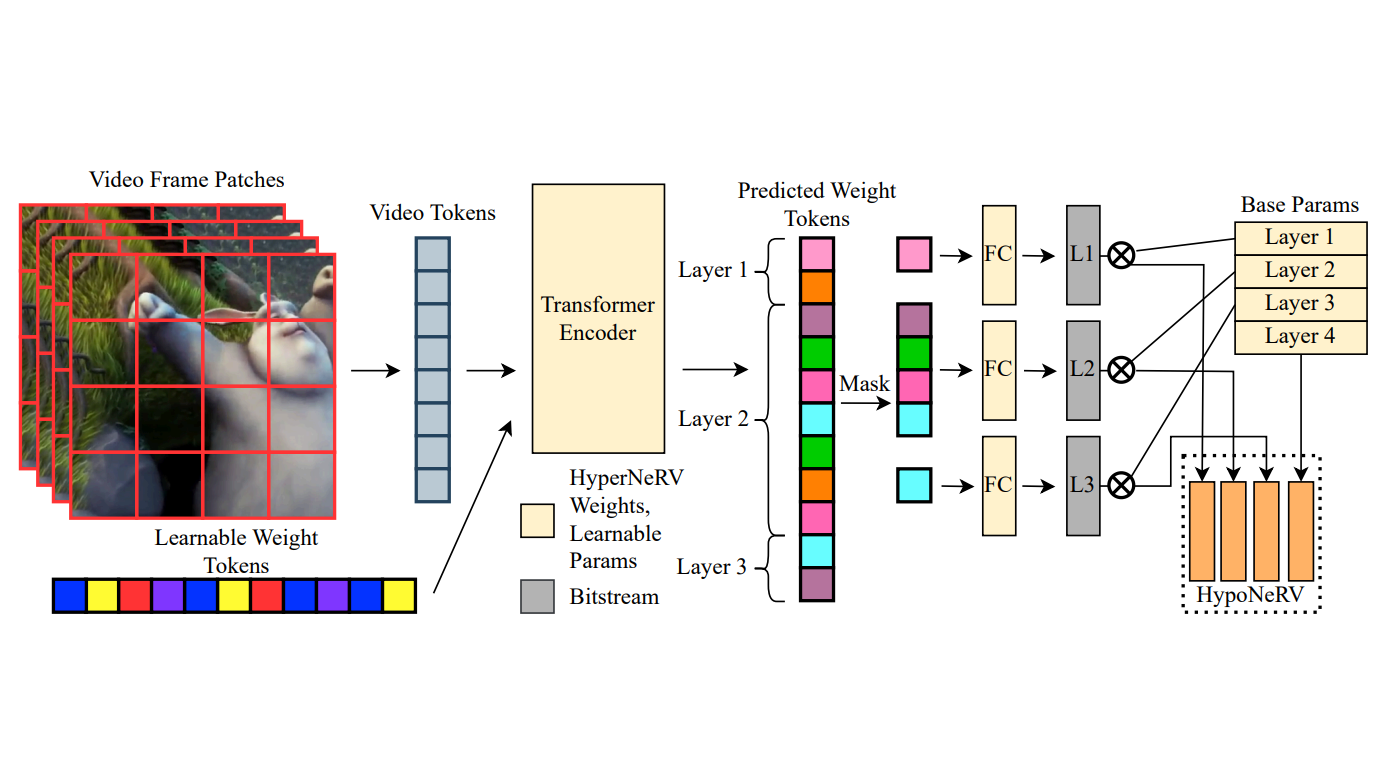
How to Design and Train Your Implicit Neural Representation for Video Compression
Matthew Gwilliam, Roy Zhang, Namitha Padmanabhan, Hongyang Du, Abhinav Shrivastava
WACV 2026
TL;DR: A practical guide to designing and training neural networks that compress videos.
How to Design and Train Your Implicit Neural Representation for Video Compression
Matthew Gwilliam, Roy Zhang, Namitha Padmanabhan, Hongyang Du, Abhinav Shrivastava
WACV 2026
TL;DR: A practical guide to designing and training neural networks that compress videos.
VideoHallu: Evaluating and Mitigating Multi-modal Hallucinations for Synthetic Videos
Zongxia Li*, Xiyang Wu*, Yubin Qin, Hongyang Du, Guangyao Shi, Dinesh Manocha, Tianyi Zhou, Jordan Lee Boyd-Graber
NeurIPS 2025
TL;DR: A benchmark showing that AI models still miss obvious errors in AI-generated videos.
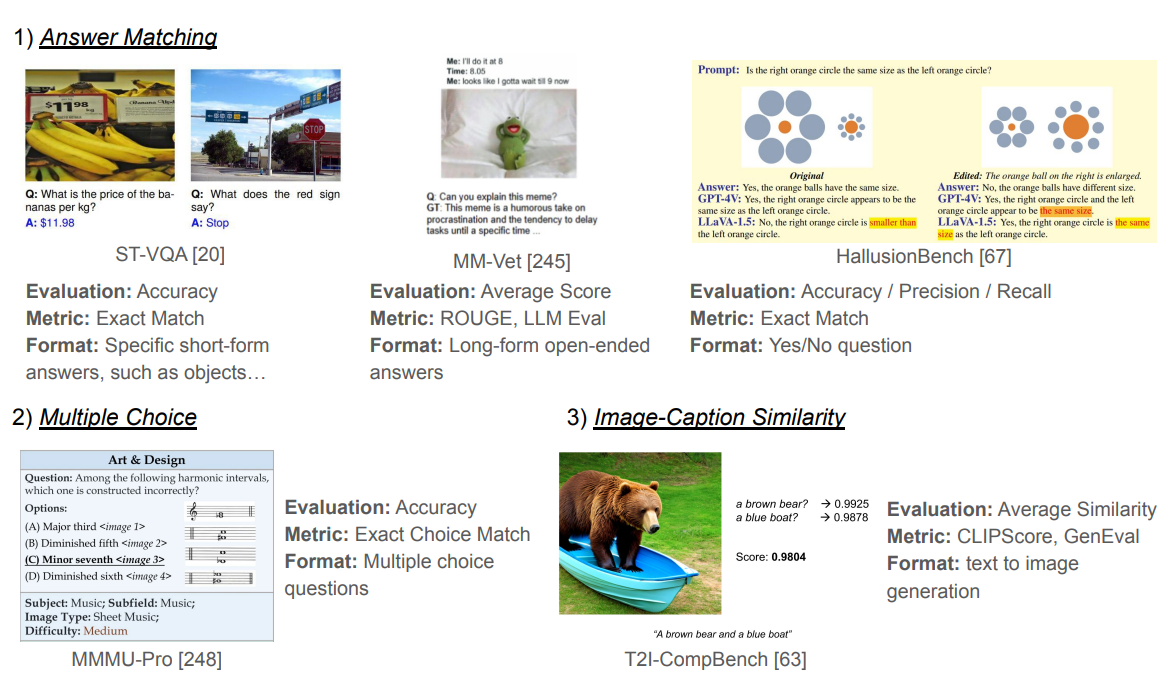
A Survey of State of the Art Large Vision Language Models: Alignment, Benchmark, Evaluations and Challenges
Zongxia Li*, Xiyang Wu*, Hongyang Du, Huy Nghiem, Guangyao Shi
CVPR Workshop 2025 Oral
TL;DR: A survey of large vision-language models.
A Survey of State of the Art Large Vision Language Models: Alignment, Benchmark, Evaluations and Challenges
Zongxia Li*, Xiyang Wu*, Hongyang Du, Huy Nghiem, Guangyao Shi
CVPR Workshop 2025 Oral
TL;DR: A survey of large vision-language models.
2024
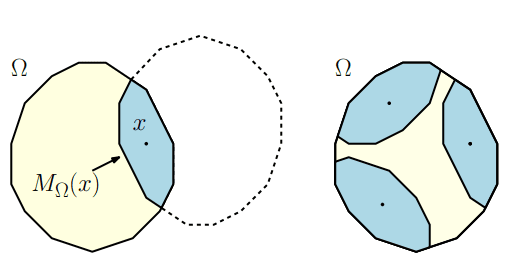
Ipelets for the Convex Polygonal Geometry
Nithin Parepally, Ainesh Chatterjee, Auguste Gezalyan, Hongyang Du, Sukrit Mangla, Kenny Wu, Sarah Hwang, David Mount
40th International Symposium on Computational Geometry (SoCG) 2024
TL;DR: New Ipe plugins for drawing and exploring convex polygon geometry.